数据 ≠ 信息 ≠ 知识 ≠ 决策——为何 AI 模糊了组织无法承受的边界

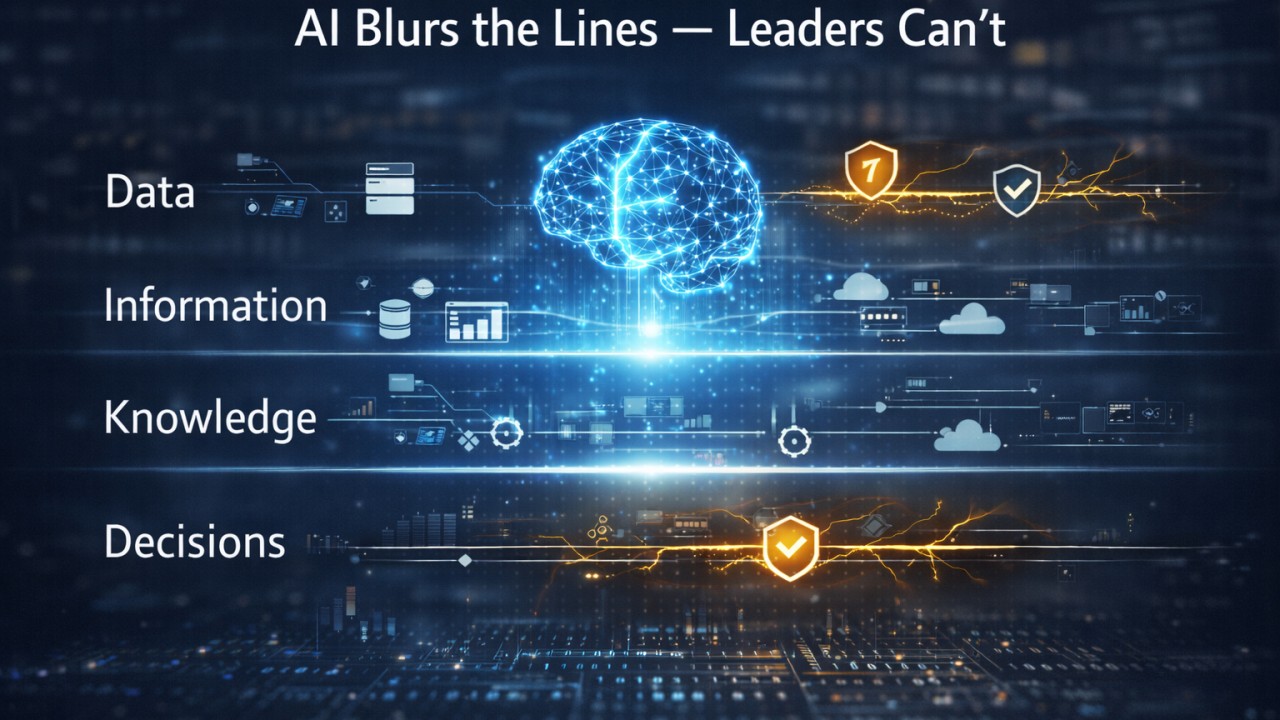
数据 ≠ 信息 ≠ 知识 ≠ 决策——为何 AI 模糊了组织无法承受的边界
企业 AI 中最悄无声息的失败,并不是模型质量。
而是类别的坍塌。
现代 AI 系统——尤其是大语言模型(LLM)——非常擅长把数据、信息、知识和决策变得看起来像同一回事。
但它们并不是。
而当组织任由这些层级变得模糊时,它们得到的就不只是糟糕的答案,而是糟糕的结果。
DIKW 金字塔依然重要(即便 AI 装作它不重要)
早在 AI 的炒作周期之前,组织就依赖一个简单却经久耐用的模型:
- 数据——原始事实
- 信息——带上下文的数据
- 知识——经过解读的理解
- 决策——付诸实施的行动
AI 并没有让这套模型过时,只是让违反它变得更容易了。
大语言模型之所以会坍塌这些层级,是因为:
- 它们检索数据
- 概括信息
- 生成看似知识的解释
- 推荐行动——全都在同一次回复里
那种压缩感很神奇,但也危险。
检索不等于理解
许多企业 AI 项目都在悄悄偷换概念:
把"模型找到了它"当成"系统理解了它"
检索增强生成(RAG)很强大——但它并不会魔法般地把文档变成知识。
它真正做的是:
- 抓取相关文本
- 对语言做模式匹配
- 生成看似合理的综合结论
那不是理解,那是流利。
没有明确的语义结构,模型根本不知道:
- 哪些概念是等价的
- 哪些术语是被重载的
- 哪些区分在运营上至关重要
这就是为什么组织会自信满满地部署这样一些系统,它们:
- 听起来是对的
- 引用了正确的文档
- 却仍然做出错误的决策
当知识(不经意间)变成了决策
企业 AI 中最危险的时刻,是知识输出悄无声息地变成了执行。
例如:
- 一条建议变成了自动化动作
- 一份摘要变成了对政策的解读
- 一个提议变成了系统更新
没有会议,没有审批,也没有明确的决策边界。
系统并没有做决定。是组织没能界定决策究竟在哪里发生。
为什么大语言模型天生就会模糊边界
大语言模型是为连续性而优化,而非为正确性而优化。
它们:
- 不会自然地暴露不确定性
- 不会强制执行决策阈值
- 不区分"告知"与"行动"
除非你明确地架构出这些边界,否则模型会自信满满地、愉快地越过它们。
这不是模型的缺陷,而是架构上的责任。
组织需要的不是更聪明的 AI——而是更清晰的层级
解决办法不是更好的提示词。
而是更好的分离:
- 保持权威性的数据系统
- 编码含义的语义层
- 支撑推理的知识系统
- 强制问责的决策系统
AI 应当在层级之内提供协助——而不是悄无声息地把它们压成一团。
控制始于清楚你到底要让 AI 做什么
在问之前:
"AI 能处理这件事吗?"
领导者应该问:
- 这是数据,还是一项决策?
- 这是信息,还是权威?
- AI 是在为判断提供信息——还是在取代判断?
因为一旦这些界线模糊,控制权就会迅速消失。
AI 可以穿越各层级——数据、信息、知识和决策——但企业必须掌控它们。
如果你的 AI 给出一个直接导向行动的答案——那是一条建议,还是你的组织从未有意识地做过的决定?
当你的 AI 采取行动时,你能指出它支持的是哪一项具体的人类决策吗——还是边界早已消失了?
如果监管者追问是谁做的决定,你的 AI 架构能给出一个清晰的答案吗?