每个 AI 系统都必须发出的五个信号

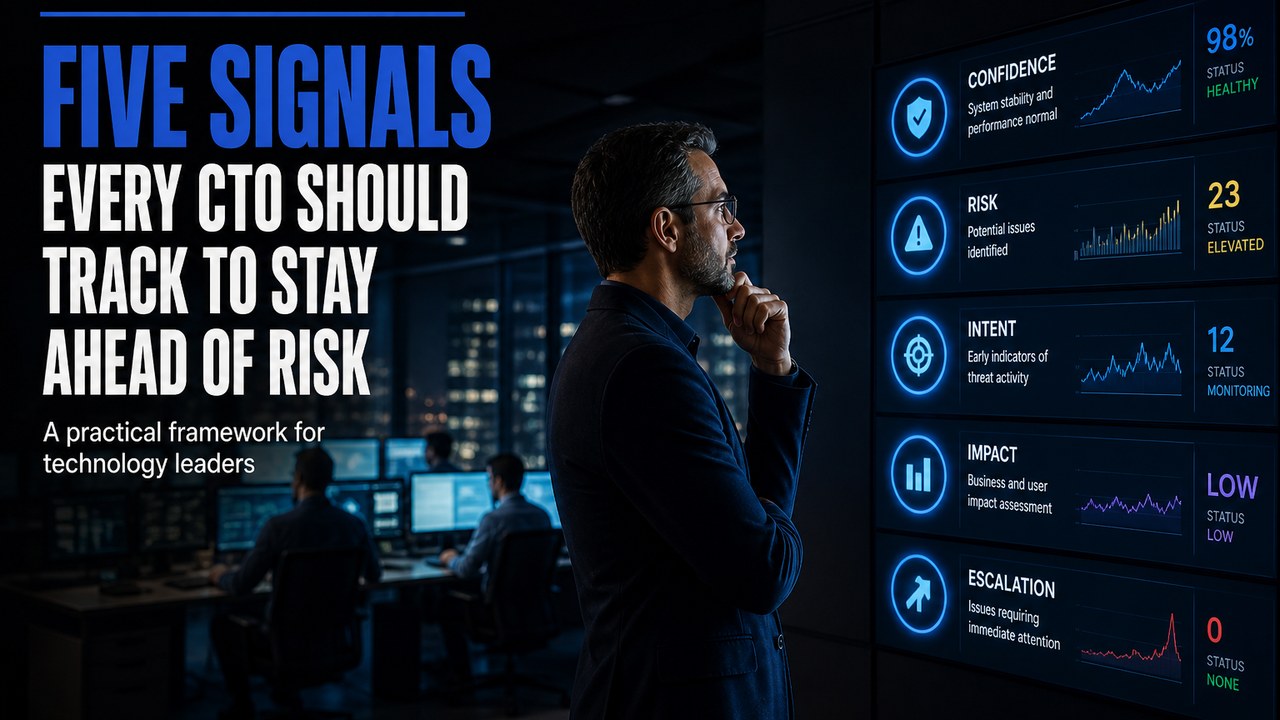
大多数投入生产的 AI 系统都在盲目运行,而操作者要等到有东西起火时才知道。
经典的软件 stack 处处都有遥测:指标、日志、追踪、仪表盘、警报。数据库变慢时,有人第一分钟就能看到。API 报错激增时,值班人员会被呼叫。系统之所以可观测,是因为团队从一开始就把可观测性内建了进去。
AI 系统却一样都没有。模型被当成一个魔法盒子——你给它输入,它返回输出,如果输出错了,没人知道,直到客户先发现。模型是你 stack 里最不可预测的组件,却也是你最少观察的那个。这完全反了。
解决办法是五个信号。每个投入生产的 AI 系统都应该发出它们,并且它们应该汇聚到同一个仪表盘上。有了这五个,你就能像运营其他一切那样运营 AI。没有的话,你就是在瞎猜。
五个信号
信号一:置信度。模型对自己答案正确可能性的自我估计。这是信任的原材料——这个数字告诉你,输出是可以直接采用的,还是需要人来介入。要追踪它的分布,而不只是平均值,因为平均值会掩盖危险的尾部。一个平均置信度 0.9、但在面向客户的请求上偶尔跌到 0.4 的系统,是一个有漏洞的系统。
信号二:延迟。从请求到响应的时间。AI 的延迟不同于普通延迟,因为它变化极大——短提示词和长提示词、冷模型和热模型,差距可能高达十倍。要追踪尾部,而不是均值。p95 延迟才是你的用户真正感受到的数字。
信号三:升级率。被转交给人工处理的输出所占的百分比。这是没人追踪的健康信号,却也是信息量最大的一个。升级率是业务在告诉你它有多信任 AI。当模型退化、数据漂移、任务变难时,它就会上升。不断攀升的升级率,是系统走偏的最早警告。
信号四:否决率。在输出发布之前,被人工主动修改的输出所占的百分比。升级说的是“这个需要人”。否决说的是“人不同意 AI”。两者之间的差距,就是模型真实的错误率;而它的趋势,就是模型真实的质量。正是这个信号,把“AI 感觉不对劲”变成了一串数字。
信号五:漂移。输入、输出和置信度的分布随时间发生的变化。世界在变,模型的性能也随之而变。漂移这个信号捕捉的正是那种缓慢的衰退——数据源改了格式、客户结构发生了偏移、问题模式发生了演化。等到准确率明显下降时,漂移其实已经运行了好几周。
五个信号 are confidence, latency, escalation, override, and drift. They're the vital signs of an AI system, and they're the difference between operating and guessing.
一个仪表盘
这些信号只有落到某个看得见的地方才算数。一个仪表盘,五个面板,不要更多。操作者应该能在三十秒内看完它,并回答三个问题:系统现在健康吗?它是在变好还是变坏?最近发生了什么变化?
仪表盘正是这些信号汇聚成故事的地方。置信度下降的同时升级率上升,意味着模型越来越不自信,而业务也察觉到了。否决率飙升而升级率持平,意味着人们正在悄悄修正那些从未进入审核队列的错误。某个输入源上的漂移在攀升,意味着上游发生了变化,该去查了。
这些面板不必花哨。每个信号一条时间序列,每个信号一条阈值线,再加上一种颜色——绿、黄、红。仪表盘是模型与操作者之间的翻译层,它唯一的任务,就是让 AI 的健康状况像数据库的健康状况一样一目了然。
信号告诉你什么,以及何时
这些信号是预警系统,而且每一个都有各自的提前量。
漂移最早。它在其他一切还没动静之前几周就开始了,告诉你模型脚下的世界正在改变。其次是升级——业务开始察觉,比率逐步攀升。接着是否决——人开始承担更多工作。置信度和延迟是滞后的,当问题已经真实发生时它们才会动。
操作者的职责,就是抓住早期信号,趁系统还健康时采取行动。漂移在攀升——现在就查数据源,别等准确率崩了再查。升级率在往上走——在队列变成焦点之前,先审视任务、提示词和模型版本。这些信号不能预测未来,但能给你在事故发生之前行动的提前量。
构建成本
五个信号听起来像个大项目,其实只要一周。置信度来自模型自身的输出。延迟来自请求路径。升级和否决来自审核工具——你本来就应该有。漂移来自记录输入分布。把五个接进仪表盘,各自设一条阈值,就完事了。
跳过这一步的团队,会用事故来付出代价。AI 做错了事,没人知道它错多久了,没人知道波及多广,调查只能从零开始。五个信号并不能阻止错误——没有任何遥测能做到。但它们会告诉你它从哪一天开始、波及到了什么范围,以及需要怎样的修复。
模型是你 stack 里最不可预测的组件。就按它的真实身份去盯它。五个信号,一个仪表盘,三十秒读完。这就是整个可观测层,也是“运营你的 AI”与“指望它自我运营”之间的区别。