AI 作为技术栈的一个新层(以及为什么还没有人拥有它)

Richard Teachout
Ashley Furniture Industries 首席技术官 —— 高管级技术领导者、创业者、AI 领导者、架构师、问题解决者、前开发者。
2026 年 2 月 6 日
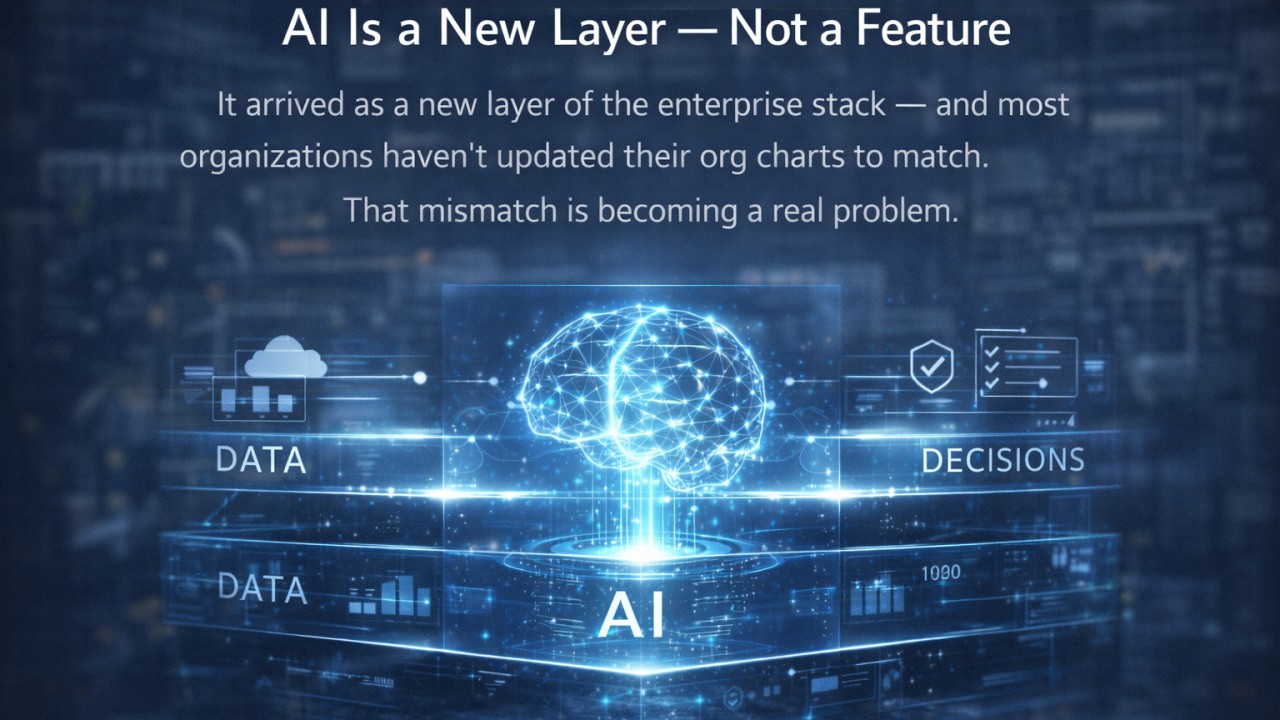
AI 作为技术栈的一个新层(以及为什么还没有人拥有它)
AI 不是作为一个功能到来的。
它是作为企业技术栈的一个新层到来的——而大多数组织还没有据此更新自己的组织结构图。
这种错配正在变成一个真正的问题。
AI 并不适合我们一直试图安放它的那些地方
组织们一直在问:
- AI 是一个数据问题吗?
- 它是一个应用功能吗?
- 它是基础设施吗?
- 它是安全团队的责任吗?
答案让人不舒服:
AI 既是以上所有,又不完全属于其中任何一项。
这正是归属总从裂缝中漏掉的原因。
AI 实际处于技术栈的哪个位置
传统上,企业技术栈大致长这样:
- 基础设施
- 平台
- 数据
- 应用
- 业务流程
AI 并没有取代其中任何一层。
它横贯所有层级:
- 它消费数据
- 在应用内部执行
- 依赖基础设施
- 影响业务决策
- 改变工作流和权限
这让 AI 不太像一个组件,而更像一个控制平面。
而控制平面需要有人来拥有。
没人想要的那个归属缺口
由于 AI 横跨多个层级,责任往往默认落到:
- “数据团队”
- “应用团队”
- “平台团队”
- “创新小组”
- “供应商”
这通常意味着:
实际上没有人在端到端地拥有它。
这会导致一些可预见的失败:
- AI 决策出错时没有清晰的问责
- 层级之间的安全缺口
- 治理被应用得太晚
- 业务负责人对系统行为感到意外,却不知道自己其实批准过它们
AI 不会轰轰烈烈地失败,它会在组织层面失败。
归属是件难事。我们还没有答案,但我们会想出办法——希望不是用惨痛的代价换来的。
组织设计正在落后于技术现实
大多数企业仍然围绕以下东西来组织:
- 记录系统
- 互动系统
- 清晰的功能边界
AI 打破了这些假设。
它:
- 生成内容,而不只是存储内容
- 给出推荐,而不只是检索数据
- 代表用户行动,而不只是等待指令
但组织结构图仍然假设 AI“只是又一个工具”。事实并非如此。
如果人人都在用 AI,那么谁来负责?
这是高管们再也无法回避的张力:
如果:
- 每个团队都在使用 AI
- 每个工作流都嵌入了 AI
- 每个决策都受到 AI 影响
那么归属就不能是可选项。
没有清晰归属的分散使用会导致:
- 无人认领的风险
- 影子自动化
- 不清晰的升级路径
- 治理作秀而非真正的控制
AI 需要一个被点名的负责人——即使它是共享的
这并不意味着要创建一个拥有一切的“AI 部门”。
它意味着:
- 对 AI 行为的明确问责
- 对语义、权限和边界的清晰归属
- 在 AI、人和系统之间定义清晰的接口
- 跨越层级而非孤岛的治理
归属不会拖慢 AI,反而会让它能够存活下去。
真正的问题不是 AI 该放在哪里
而是这个:如果一个由 AI 驱动的决策造成了伤害、延误或损失——谁要为它负责?
在组织能够清晰地回答这个问题之前,AI 就不是技术栈的一层。
它是漂浮在各层之间的一个负担。