AI 系统的业务连续性:在出问题之前,运营者需要知道什么

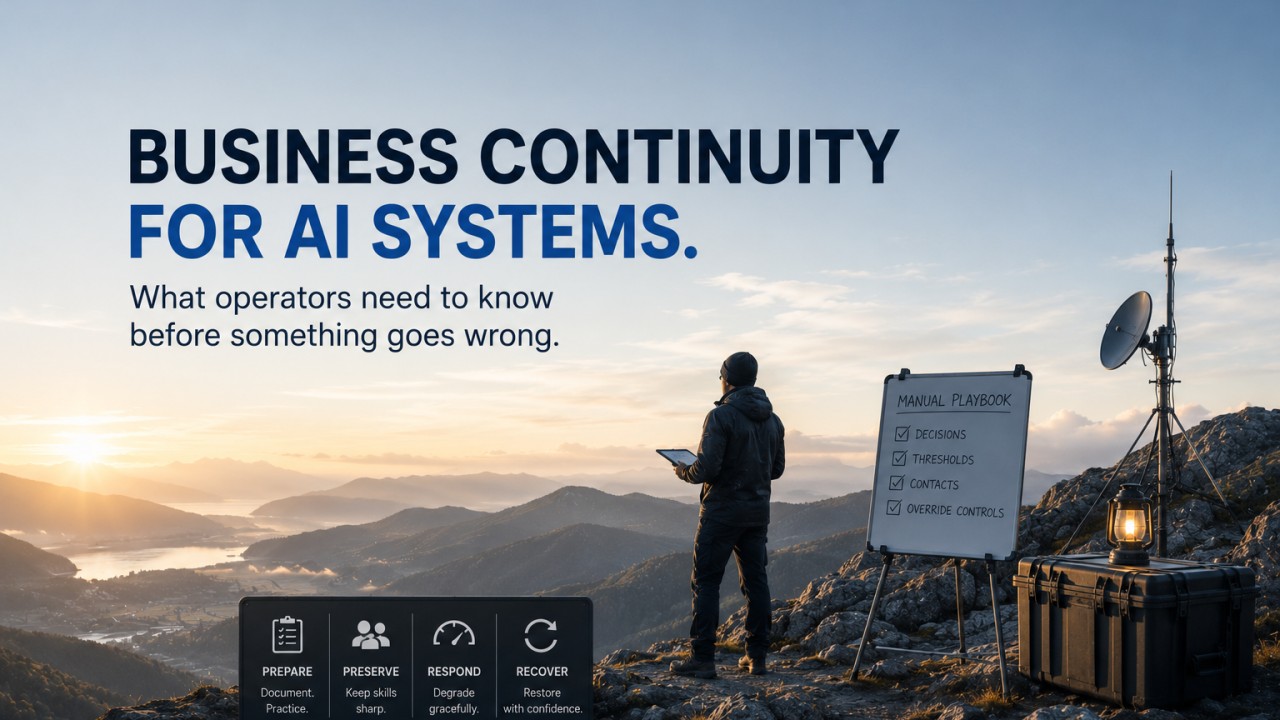
AI 系统的业务连续性:在出问题之前,运营者需要知道什么
我们总是为 AI 系统最好的状态而设计,用晴天场景来测试它们,并针对准确性、速度和覆盖度进行优化。但那些能在生产环境中多年维持 AI 系统的团队做的却不同:他们会为系统完全不可用的时刻而设计。
这不是悲观,而是运营上的成熟。驱动其他所有关键系统进行业务连续性规划的那套纪律,同样适用于 AI。而且当它做得好时,会增强——而非削弱——人们对技术的信心,因为每个人都知道组织已为接下来可能发生的一切做好了准备。
那个改变一切的问题
我曾向几十个在生产环境中运营 AI 的团队问过一个直截了当的问题:“如果你们的 AI 系统今天中午宕机,你们的团队能在下午 2 点前接手手动处理这个量吗?”
大多数团队会停顿一下。有人承认自己不知道。少数人意识到答案是否定的——而且手动运行这套流程所需的技能早已退化。
这不算失败,而是一个只要准备得当就完全可以填补的空白。
准备充分的团队会怎么做
那些能以最小干扰应对 AI 系统故障的组织,遵循三项做法:
1. 他们维护真正可用的手动操作手册。不是躺在合规文件夹里的 50 页文档,而是单页的运行清单,回答这些问题:这个系统做哪些决策?哪些阈值会触发哪些动作?每个严重级别该联系谁?覆盖控制在哪里?这些手册要通过演练来检验,而不是写完了就归档。
2. 他们让运营者定期接触手动流程。技能退化的风险是真实存在的。当一个系统已经稳定运行了好几个月,那些知道如何在没有它的情况下运行流程的人,早已转去做其他工作了。最好的团队会安排周期性的“熄灯”演练——用 30 分钟有意绕过系统,让运营者手动跑一遍工作流样本。这不是不信任系统,而是为了保住机构的能力。
3. 他们设计优雅降级,而不只是完整故障转移。一个二元的系统——要么全自动、要么全手动——是脆弱的。最具韧性的系统拥有中间状态。也许系统继续运行,但对超过某个阈值的一切动作都要求明确确认。也许它会变慢但不停止。也许它按范围降级——继续运行某个工作流,同时暂停另一个。这些中间状态在事故期间保住了价值,也减轻了紧急修复的压力。
充分准备的好处
令人鼓舞的现实是:投资于 AI 业务连续性的组织,很少真正需要用到它。准备这个动作本身——记录流程、演练手册、交叉培训运营者——就能暴露空白并建立信心,而系统本身也因此受益。
知道自己能扛过系统故障的团队,在正常运营中会更愿意信任系统。安全网让钢丝绳显得更宽。
从小处开始。挑一个真正重要的 AI 工作流。问一问那个“中午”问题。如果答案不够清晰,你就找到了第一个建立韧性的机会。