Data Rot: How to Catch It Before the Model Learns It

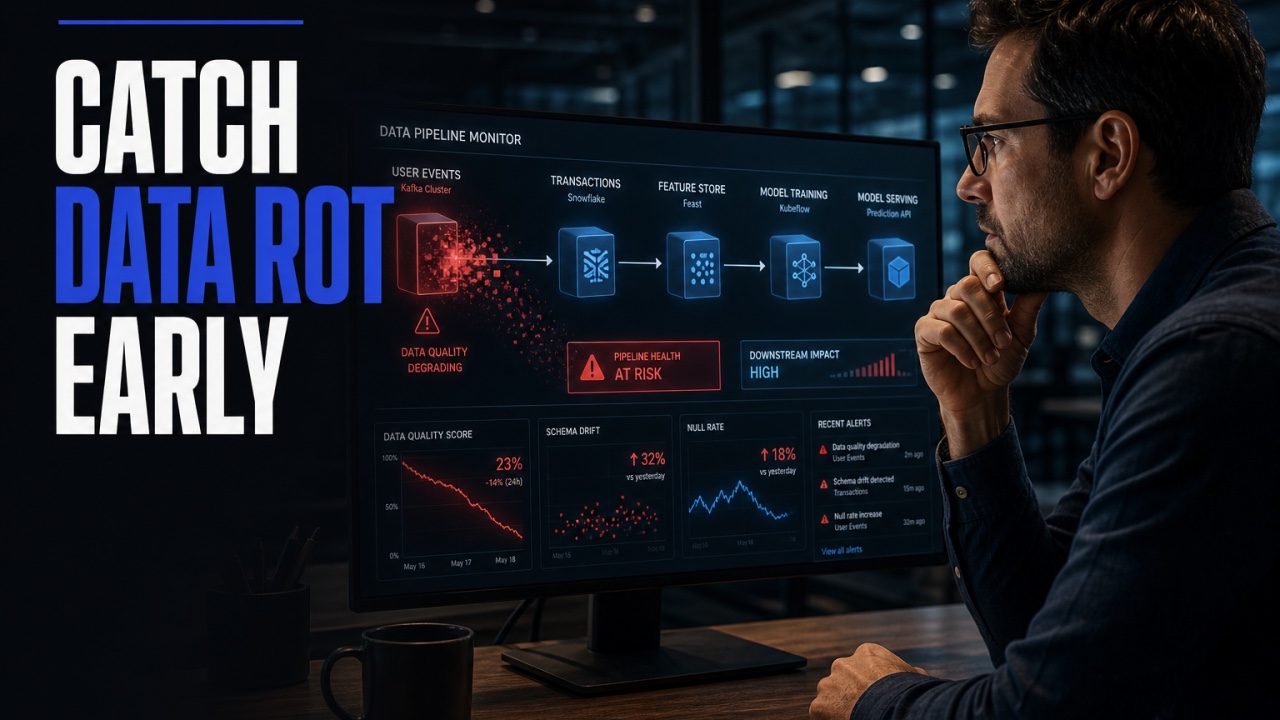
数据正在腐化,而模型正在学习这种腐化。
这是 AI 系统最安静的失败,直到损害已经造成,没有人会看见。模型不会崩坏。它会退化——缓慢地、悄无声息地,朝着被喂给它的数据的方向退化。数据源改变了格式。过去代表一个意思的字段,现在代表另一个意思。过去完整的记录,现在只剩一半。而模型,勤勉地,学会了这个新现实——尽管它是错的。
数据腐化从设计上就是隐形的。系统不会报错。它只是每次变差一点点,而输出以一种从内部难以察觉的方式漂移。等到有人发现时,模型已经学习错误的东西好几周了,而修复不是打个补丁。是重新教育。
为什么模型让情况更糟
模型是数据腐化的放大器,而这正是大多数团队没有意识到的地方。
数据混乱的软件通常会大声地失败——模式崩溃、查询报错、报表返回空白。AI 则不同。它吸收混乱。缺失的字段成为模型的新常态。改变的格式成为新的模式。模型不会抱怨数据质量问题。它把数据质量问题吸收进去,它产出的每一个结果都带着腐化前行。
这就是放大效应。腐化原本只在一个数据源里,现在它出现在模型给出的每一个答案里。模型把一个局部的数据问题分发到了整个系统。尽早抓住腐化不只是关于数据。是阻止放大。
数据腐化是缓慢的失败。模型把它变成快速的失败——吸收混乱,再把它分发到各处。抓住它必须发生在模型学会这个教训之前。
抓住它的漂移检查
你无法手动盯着数据——太多了。你需要检查,而且它们要按计划运行。
分布检查:针对模型依赖的每个字段,随时间追踪数值的分布。过去有五个取值的分类字段,现在有七个。均值移动了的数值字段。长度分布偏移了的文本字段。分布不会无缘无故移动。当它们移动时,上游某个地方发生了变化,而你要在模型之前知道。
新鲜度检查:数据还在到达吗?过去每小时更新的流水线,现在每天更新。悄然停止包含记录的馈送。完整性检查是同一类——过去 99% 时间都有值的字段,现在只有 80%。这些检查能在早期抓住腐化,当它还只是流水线问题而不是模型问题时。
语义检查:数据还是它自称的那个东西吗?这是最难的检查,也是抓住代价最高昂的腐化的那个。含义改变了的字段。单位改变了的。ID 方案改变了的。分布检查抓不住一个看起来相同、含义却不同的字段。语义检查需要一个领域负责人——一个查看样本并问“这还是原来那个东西吗?”的人。这是人工检查,值得排上日程,因为代价高昂的腐化是语义层面的。
每周数据健康审查
检查会生成警报。警报需要一个按计划审视全局的人。
每周数据健康审查是三十分钟,每周同一时间。漂移报告、新鲜度报告、样本批次。操作者过一遍报告,回答一个问题:数据还是模型以为的那个数据吗?大多数周答案是肯定的,会议也很短。答案是否定的那几周,就是审查体现价值的时候——腐化在流水线阶段就被抓住,早于模型有一周时间去学会它。
审查也是语义检查发生的地方。领域负责人查看数据样本和模型输出,标记出分布看不到的悄然变化。审查是让自动化检查值得信赖的人工层——检查说出什么移动了,人判断这个移动是否重要。
让模型保持诚实的循环
数据健康审查在警报之外还有第二个产出:它喂养评测套件。分布偏移成为一个新的评测用例。语义变化成为黄金集条目。被抓住的腐化成为一个回归测试,这样下次同样形态的变化出现时,评测套件会在审查之前就抓住它。
这就是复利式的循环。每一次腐化事件都让系统更擅长抓住下一次,因为每一次都为套件增加一个用例、为流水线增加一项检查。数据健康审查不再是一项杂务,而成为让整个系统保持诚实的传感器。
模型学会你喂给它的东西。腐化就在喂养之中。分布检查、新鲜度检查、语义检查、每周审查,以及一个把每次捕获都变成测试的循环。这就是实践,也是一个保持敏锐的模型与一个缓慢、悄然学会犯错的模型之间的区别。盯着数据。模型会照顾好它自己。