从幻觉到事故:信心如何放大风险(v2)

从幻觉到事故:信心如何放大风险(v2)
当「听起来对」比「真的对」更重要
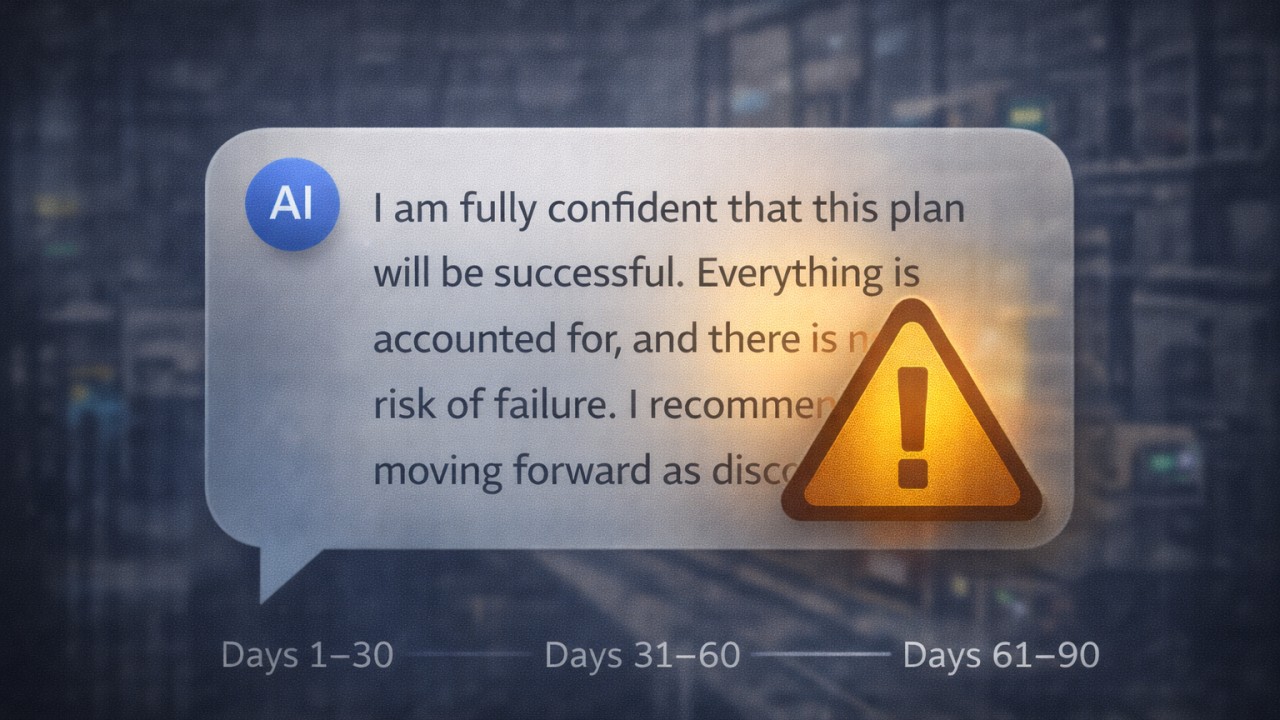
错误的答案是问题。
自信的错误答案是一种运营风险。
随着 AI 系统变得更流畅、更快、更深入地嵌入日常工作中,组织内部正在发生一种微妙的变化:我们不再只是评估系统说了什么——我们是在对它「说得多有说服力」做出反应。
那个转变,正是小错误悄悄变成事故的地方。
本文探讨信心如何加速风险、流畅的系统为何能绕过怀疑,以及组织如何赶在「信念超越现实」之前设计出护栏。
真正的问题不是幻觉
幻觉受到大量关注,因为它们可见。它们容易被截图、容易被嘲笑、容易被贴上「AI 出错了」的标签。
但幻觉本身很少造成损害。造成损害的是:信心与权威的结合。
当一个人工智能系统:
- 使用流畅的语言
- 给出结构化的解释
- 听起来冷静、笃定且专业
它不只是提供了一个答案,它还制造了一种心理惯性。而惯性会改变行为。
为什么自信的系统能绕过怀疑
人类天生会对信心做出反应。在高压环境中,信心常常取代确定性,因为:
- 它降低了认知负担
- 它加快决策
- 它在不确定中发出能力的信号
这就是为什么自信的发言者主导会议,为什么精良的仪表盘被信任,为什么「明确的答案」比「我不确定」更让人安心。AI 系统现在也触发了同样的反射。
当一个人工智能的回复是:
- 语法干净
- 逻辑结构清晰
- 即时交付
人类大脑常常跳过一个关键步骤:验证。不是因为人们粗心——而是因为系统感觉上很可靠。
错误如何升级为事故
大多数由 AI 驱动的事故,并不是从灾难性故障开始的。
它们遵循一个模式:
- 建议 — AI 给出一个建议或解释。
- 接受 — 输出「听起来对」,并且与预期相符。
- 传播 — 答案被复用、转发,或被嵌入下游决策。
- 强化 — 重复增加了被感知的正确性。
- 承诺 — 基于假定的有效性采取行动。
- 发现(为时已晚)— 直到影响发生之后,才有人问:「那真的正确吗?」
在任何时点,系统都不需要心怀恶意。在任何时点,都没有人打算跳过监督。是信心完成了这一切。
隐藏的风险:有权无责
在许多组织中,AI 的产出现在正影响着:
- 事故分级
- 根因分析
- 维护建议
- 排期与优先级
- 高管摘要
然而当这些产出出错时,问题往往变得模糊:
- 谁质疑过它?
- 谁批准了它?
- 谁拥有这个决定?
信心制造了隐性的权威,但大多数系统缺乏明确的责任归属。风险就栖身于这道鸿沟之中。
有意识地设计摩擦
答案不是让 AI 变得无能,而是让它变得不那么绝对。
高可靠性系统被设计成带有刻意的摩擦:
- 航空检查清单
- 医疗第二意见
- 制造质量关卡
AI 需要同样的对待。
健康的系统会:
- 明确地发出不确定性信号
- 邀请质疑,而不是压制质疑
- 放慢高影响决策
- 保留人类的仲裁
信心永远不应该移除那个暂停按钮。
成熟组织做得不一样的地方
安全地规模化 AI 的组织并不会消除错误——它们会打断升级。
它们会:
- 把流畅的输出当作输入,而不是权威
- 把解释质量与正确性分开
- 记录人类何时覆盖 AI(以及为什么)
- 在事故发生之前就设计好升级路径
最重要的是,他们不再问:「AI 对了吗?」而是开始问:「我们为什么会相信它?」
信心不是敌人——失控的信心才是
自信的系统并不坏,它们很强大。
但缺乏结构的权力不会轰然失败——它会平滑地、令人信服地、大规模地失败。
最危险的 AI 失败看起来不会混乱,它们会显得合理、听起来正确,而且行动迅速。
最后一个问题
如果它听起来是对的,会有人拦下它吗?