治理不是为了拖慢 AI。它是为了让 AI 在企业规模下真正可用。

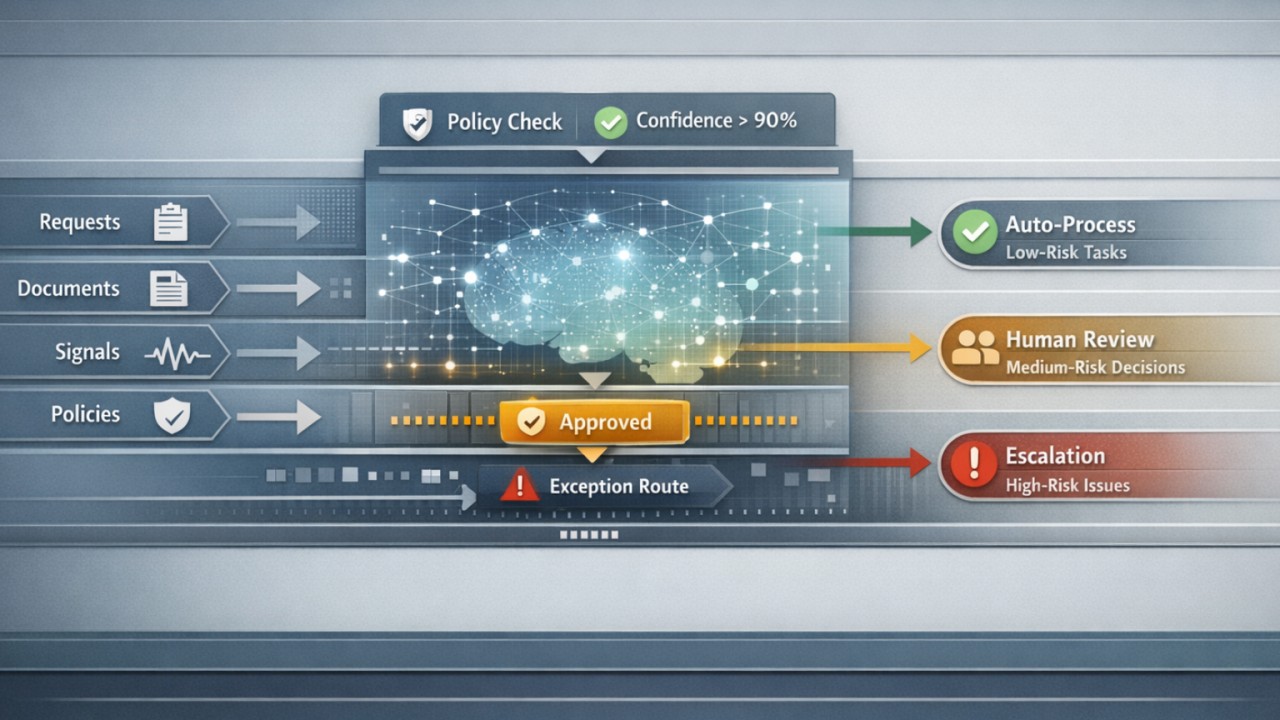
治理不是为了拖慢 AI。它是为了让 AI 在企业规模下真正可用。
许多 AI 项目停滞,是出于错误的原因。
不是因为模型弱,不是因为用例不清晰,甚至也不是因为技术不成熟。
它们停滞,是因为模型周围的工作流没有被定义。
这正是许多企业如今正在撞上的失败模式。团队能生成产出,能总结文档、起草回复、分类工单、建议行动并加速分析。但一旦产出开始触及真实的运营、真实的客户、真实的决策或受监管的流程,对话就变了。
如今问题不再是「AI 能完成这项任务吗?」
而是变成了:谁拥有这个结果,哪些控制塑造了这个决定,以及当系统出错时会发生什么?
这正是受治理的 AI 工作流变得至关重要的地方。
真正的问题不是模型智能,而是工作流的可靠性。
实际上,大多数企业 AI 的失败并非来自戏剧性的模型崩溃,而是来自简单得多的运营问题:
- 没有定义审批边界
- 对高影响产出没有明确的人类审核人
- 对模糊或例外情况没有升级路径
- 没有记录某项建议为何被接受或被推翻
- 没有区分低风险自动化与高风险增强
- 一旦试点成为生产工作的一部分,就没有共同的运营负责人
这就是为什么这么多早期的 AI 部署在演示中令人印象深刻,在业务中却脆弱不堪。
模型或许有能力,工作流却没有。
在企业规模下,信任很少仅靠智能建立,它靠的是可预测性、责任归属和决策设计。
治理不是叠加在 AI 之上的政策层,它本身就是工作流的一部分。
许多组织仍然把治理当作一个审查委员会、一份安全清单,或一份在采购后期才出现的文件。这太狭隘了。
要让 AI 在真实运营中运转,治理必须被直接嵌入工作流设计。
这意味着工作流本身就应该回答这样一些问题:
- 正在做出的是哪种决定?
- 一个错误答案的影响是什么?
- 什么信心阈值会改变处理路径?
- 人类何时批准、编辑或拒绝?
- 保留哪些证据?
- 哪些例外需要升级?
- 谁对工作流的成果负责,而不只是对模型输出负责?
这是一种不同的思维方式。
受治理的组织不会把 AI 当作插入流程的一个工具,而是设计一个受控的决策系统,让 AI 成为更大运营结构中的一个组件。
那是一种更持久的规模化方式。
最有用的模式不是完全自治,而是有边界的参与。
人们倾向于把 AI 采用框定为一个二元选择:
- 要么人类手动完成工作
- 要么 AI 端到端自动化工作
这种框定制造了不必要的风险。
大多数企业价值都处在中间地带。
最有效的受治理 AI 工作流,通常会在一段仍然拥有明确归属的序列中,赋予 AI 一个有边界的角色。例如:
- 起草回复,但在对外发送前要求审批
- 对请求分类,但把边缘案例路由到专家队列
- 建议行动,但在超过阈值时要求经理签字确认
- 总结文件,但保留来源链接和审核人的编辑
- 检测异常,但只有在基于规则的校验之后才升级
这正是工作流成熟度发挥作用的地方。
一个受治理的 AI 工作流,并不是要证明人类是多余的,而是要确保自动化发生在已知的边界之内。
信任就是这样累积起来的。
治理始于决策分层,而不是一刀切的限制
最常见的错误之一,就是把同一套控制模型套用到每一个 AI 用例上。
这在不需要摩擦的地方制造摩擦,却又在真正要紧的地方漏掉风险。
更好的做法是对决策进行分层。
例如:
第一层:低风险的生产力支持**——内部起草、总结、笔记整理、知识辅助。治理重点:数据处理、提示词边界、输出标注、使用日志。
第二层:运营建议**——工单路由、文档分类、下一步最佳行动建议、工作流优先级。治理重点:信心阈值、人工审核、例外处理、性能漂移。
第三层:高影响或对外有后果的行动**——客户沟通、定价建议、受监管案件处理、合规敏感决策。治理重点:审批关卡、决策可追溯性、审计记录、基于角色的访问控制、正式归属。
这种结构做到了两件事。
第一,它防止过度反应。并非每个用例都需要重量级的审批。第二,它防止控制不足。高影响的工作流不应被当作简单的生产力工具来对待。
当治理与决策后果挂钩、而不是与抽象的焦虑挂钩时,它才变得切实可行。
归属是许多 AI 项目中缺失的那一层
只有当归属是明确的时候,受治理的工作流才能运转。
这听起来显而易见,但这往往是项目崩溃的地方。平台团队拥有工具,安全团队拥有审查,法务拥有政策语言,业务团队拥有需求。然而,一旦 AI 在生产中影响工作,就没有人清楚地拥有这个「活」工作流。
那道鸿沟造成了熟悉的问题:
- 当产出出错时责任不清
- 部署后的监控薄弱
- 业务团队与技术团队之间未解决的交接
- 使用模式的漂移却没有流程再设计
- 只存在于纸面上、却不在运营中的治理产物
解法不只是「更多的监督」,而是指定一个真正的工作流所有者。
这个所有者对运营设计负责:
- AI 被插入在哪里
- 适用哪些边界条件
- 哪些指标表明失败或漂移
- 何时需要升级
- 人类如何介入
- 工作流如何随时间变化
没有那种归属,AI 就仍然只是一种没有控制面的能力。
好的受治理工作流让人的参与更精准,而不是更沉重
还有一种误解,认为受治理的 AI 意味着增加官僚主义。
做得差,确实如此;做得好,则不然。
最好的受治理工作流不会强迫人类重做所有工作,而是把人类的注意力集中到真正需要判断的地方。
这可能意味着:
- 只审查低于信心阈值的产出
- 随每项建议一并呈现理由和来源证据
- 自动把例外类别路由给正确的审核人
- 记录覆盖操作,以便改进模式
- 把常规案例与模糊案例分开
这比把「人在闭环中」当作口号,是一个更好的设计原则。
真正的目标,是在正确的控制点上发挥人的判断力。
不是持续的监督,不是走过场的批准,也不是盲目的信任。
只是在企业风险、模糊性或责任归属需要的地方,进行清晰的介入。
最强大的 AI 运营模式把升级当作一项设计特性
在成熟的组织中,升级不被视为失败,而被视为安全流程的一部分。
AI 工作流也应如此。
当模型不确定、当上下文不完整、当政策冲突,或当建议具有超常影响时,工作流应该知道如何放慢速度并转移控制权。
这意味着升级路径应该被有意识地设计:
- 基于信心的路由
- 由政策触发的审查检查点
- 拥有指定所有者的例外队列
- 对某些行动类型的可逆性
- 决策后抽样与回顾性审查
这是运营成熟度最清晰的标志之一。
不受治理的 AI 试图隐藏不确定性;受治理的 AI 工作流则让不确定性变得可见且可操作。
在规模化 AI 之前,领导者真正应该问什么
在批准更广泛的推广之前,领导者应该问一组更严谨的问题:
- AI 究竟处于工作流的哪个位置?
- 它能影响、建议或执行哪些决定?
- 哪些行动需要审批,由谁审批?
- 每个产出由什么证据支撑?
- 什么会被记录以供审查或审计?
- 例外如何处理?
- 谁拥有漂移、质量失败和工作流再设计?
- 当系统在 80% 的时间里是正确的、却在最重要的 20% 上出错时,会发生什么?
这些不是反 AI 的问题。
它们是把实验与企业能力区分开来的问题。
前行的道路不是更少的 AI,而是更好的工作流设计。
这里有一条前行的道路,但它需要思维上的转变。
在 AI 上取得成功的组织,不会是那些简单地部署最强大模型的组织,而是那些围绕模型设计出最清晰运营系统的组织。
因为在企业中,价值并不只来自生成产出。
它来自创建人们可以信任、领导者可以治理、运营者在压力下真正能运转的工作流。
那才是真正的成熟度曲线。
不是模型的采用,而是受治理的 AI 工作流的采用。
你的 AI 战略到底是关于智能,还是它终于迫使你去直面:决策、归属和控制在你的组织内部究竟是如何运作的?欢迎在评论里告诉我。