设定能在生产中赢得信任的置信阈值

设定能在生产中赢得信任的置信阈值
AI 团队所做的最务实的决策之一,也是最容易被忽视的决策之一:"这个系统在什么置信水平下应该升级交给人类?"
阈值设得太高,系统就会自主地犯下本应被拦截的错误。阈值设得太低,你就会让运营人员淹没在误报里。在没有证据的情况下定下一个数字,你就已经做出了一个决定系统实际吞吐量的治理决策——而没有人意识到这一点。
令人鼓舞的是:这个决策是完全可知的。那些投入精力把它做对的组织,会获得一种随时间复利增长的结构性优势。
团队把阈值设对的三种方式
我见过团队在阈值设定上从靠猜走向精准。他们遵循三种做法:
1. 他们从运营数据入手,而不是模型指标。 大多数团队犯的第一个错误,是把模型准确率当作阈值的参考。模型准确率告诉你系统在一套测试集上的表现。它不会告诉你系统在生产中出错时会发生什么。我见过的成功团队,都是先分析实际的升级结果——哪些被覆盖了、哪些被接受了、哪些被漏掉了。这些运营数据揭示了在你的具体情境下,误报和漏报的真实成本。
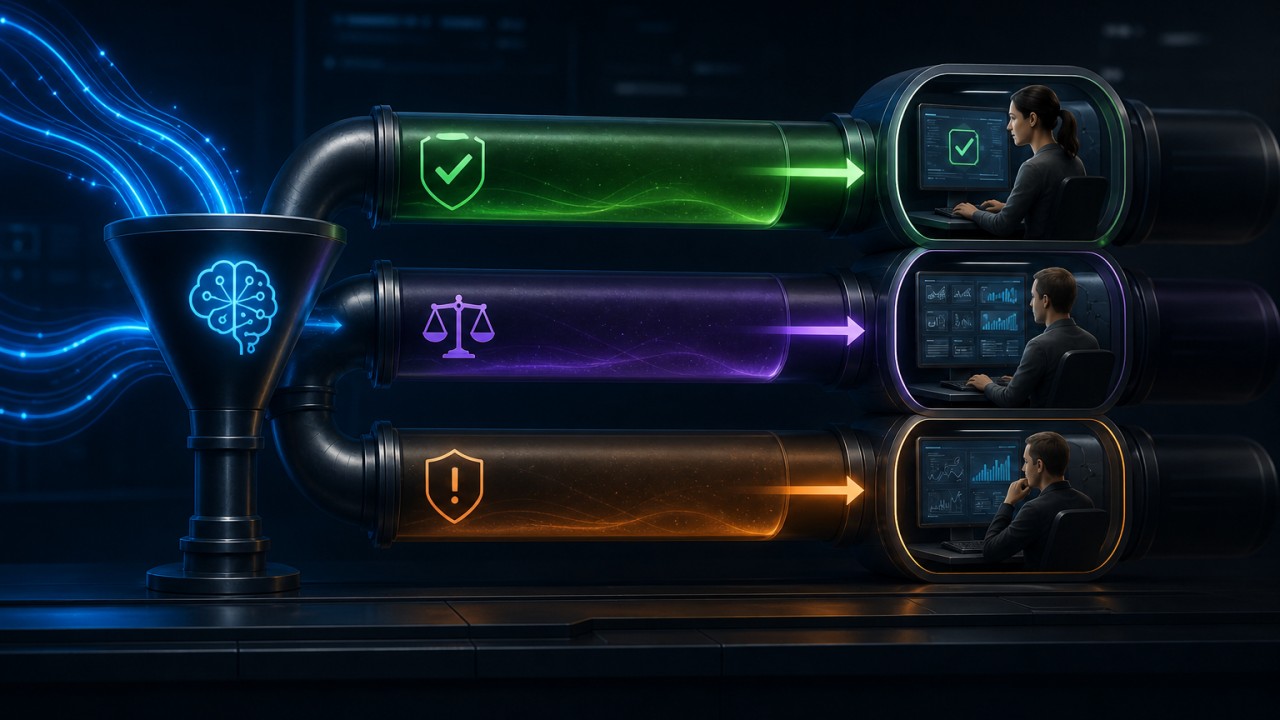
2. 他们为不同类型的决策设定不同的阈值。 在所有工作流上套用同一个阈值,是治理不成熟的表现。那些能规模化取胜的团队认识到,不同的决策有不同的后果。一个产品分类建议可以比一个定价建议容忍更低的置信度。一个内部工作流触发器可以比一个面向客户的行动更宽松。正确的抽象是"层级",而不是"数字"。
3. 他们把阈值当作动态的,而不是静态的。 最好的团队不会设一次阈值就抛之脑后。他们会监控升级率、覆盖模式以及反馈循环。随着系统改进,阈值会收紧——在 AI 已经赢得信任的地方给予它更多自主权。这就形成了一个良性循环:系统赢得信任,信任带来更多自主权,更多自主权产生更多数据,而更多数据又改进系统。
一个入门框架
如果你是第一次设定阈值,想要一个务实的方法,下面是一个框架:
- 绘制后果。 对于系统做出的每项决策,估算一次错误的自主决策的成本,对比一次不必要升级的成本。
- 用观测到的数据来校准。 让系统以影子模式或带人工审核的方式运行两周。把置信分数和运营者的决策一起记录下来。你很快就能找到系统可靠正确的那条阈值,以及不确定性开始损害质量的那个点。
- 建立审查节奏。 在每次重大模型更新之后、每次业务量增长 10 倍之后,以及至少每季度一次,安排一次阈值审查。阈值不是图表上的一个数字,而是一个治理决策,应该随着系统的成熟而不断重新审视。
置信阈值不是一个技术细节。它是你将做出的杠杆最高的治理决策之一。把它们设对了,你的 AI 就会用最传统的方式赢得信任:通过持续、可观察的表现。