Data Rot: How to Catch It Before the Model Learns It

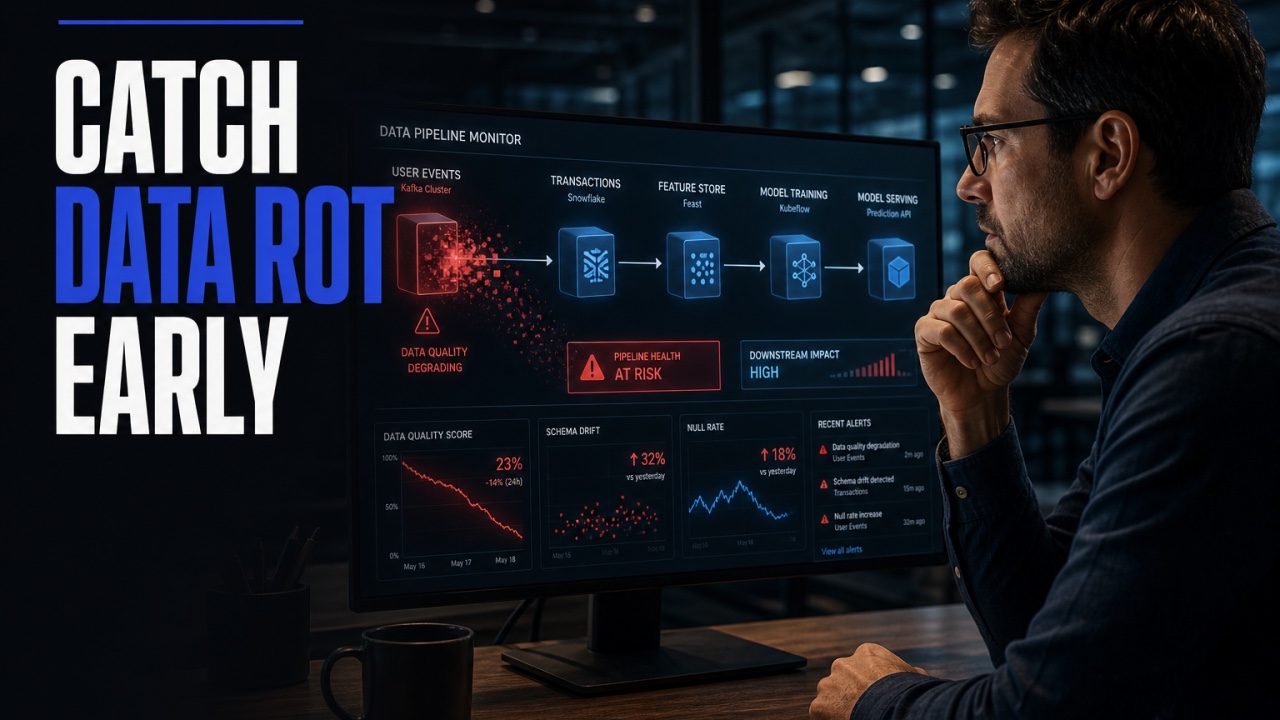
Dữ liệu đang mục nát, và mô hình đang học theo sự mục nát đó.
Đó là thất bại thầm lặng của các hệ thống AI, và không ai nhìn thấy cho đến khi thiệt hại đã xảy ra. Mô hình không hỏng. Nó suy giảm — chậm rãi, vô hình, theo hướng dữ liệu đang được nạp vào nó. Nguồn dữ liệu đổi định dạng. Trường từng mang một nghĩa giờ mang nghĩa khác. Các bản ghi từng đầy đủ giờ trống một nửa. Và mô hình, một cách chăm chỉ, học lấy thực tế mới — dù nó sai.
Sự mục nát dữ liệu vô hình theo thiết kế. Hệ thống không báo lỗi. Nó chỉ tệ đi, từng chút một, và đầu ra trôi dạt theo những cách khó nhận ra từ bên trong. Đến khi ai đó phát hiện, mô hình đã học điều sai trong nhiều tuần, và việc sửa không phải là một bản vá. Đó là tái đào tạo.
Tại sao mô hình khiến nó tệ hơn
Mô hình là bộ khuếch đại sự mục nát dữ liệu, và đó là điều mà hầu hết các nhóm không nhận ra.
Phần mềm với dữ liệu lộn xộn thường hỏng một cách ồn ào — schema vỡ, truy vấn báo lỗi, báo cáo trả về trống rỗng. AI thì khác. Nó hấp thụ sự lộn xộn. Trường bị thiếu trở thành trạng thái bình thường mới của mô hình. Định dạng thay đổi trở thành mẫu mới. Mô hình không phàn nàn về vấn đề chất lượng dữ liệu. Nó hấp thụ vấn đề chất lượng dữ liệu, và mọi đầu ra nó tạo ra đều mang sự mục nát về phía trước.
Đó là sự khuếch đại. Sự mục nát từng nằm trong một nguồn dữ liệu, giờ nó nằm trong mọi câu trả lời mô hình đưa ra. Mô hình đã biến một vấn đề dữ liệu cục bộ thành vấn đề phân tán khắp hệ thống. Phát hiện sự mục nát sớm không chỉ là về dữ liệu. Mà là ngăn sự khuếch đại.
Sự mục nát dữ liệu là thất bại chậm. Mô hình biến nó thành thất bại nhanh — hấp thụ sự lộn xộn và phân tán nó khắp nơi. Việc phát hiện phải xảy ra trước khi mô hình học được bài học.
Các kiểm tra độ trôi giúp phát hiện nó
Bạn không thể theo dõi dữ liệu thủ công — có quá nhiều. Bạn cần các kiểm tra, và chúng chạy theo lịch.
Kiểm tra phân phối: với mỗi trường mô hình phụ thuộc, theo dõi phân phối giá trị theo thời gian. Trường phân loại từng có năm giá trị giờ có bảy. Trường số có trung bình dịch chuyển. Trường văn bản có phân phối độ dài thay đổi. Phân phối không tự nhiên di chuyển. Khi chúng di chuyển, thứ gì đó ở thượng nguồn đã thay đổi, và bạn muốn biết trước cả mô hình.
Kiểm tra độ mới: dữ liệu có đang đến không? Pipeline từng cập nhật mỗi giờ giờ cập nhật mỗi ngày. Nguồn cấp âm thầm ngừng đưa vào các bản ghi. Kiểm tra tính đầy đủ là cùng một họ — trường từng được điền 99% thời gian giờ chỉ còn 80%. Đây là các kiểm tra phát hiện sự mục nát sớm, khi nó còn là vấn đề pipeline chứ chưa phải vấn đề mô hình.
Kiểm tra ngữ nghĩa: dữ liệu có còn đúng như nó tự nhận không? Đây là kiểm tra khó nhất và là kiểm tra phát hiện sự mục nát đắt đỏ. Trường đã đổi nghĩa. Đơn vị đã thay đổi. Sơ đồ ID đã thay đổi. Kiểm tra phân phối sẽ không bắt được một trường trông giống hệt nhưng mang nghĩa khác. Kiểm tra ngữ nghĩa cần một chủ sở hữu lĩnh vực — người xem mẫu và hỏi "đây có còn là thứ nó từng là không?" Đó là kiểm tra của con người, và đáng được đưa vào lịch, bởi sự mục nát đắt đỏ nằm ở ngữ nghĩa.
Đánh giá sức khỏe dữ liệu hằng tuần
Các kiểm tra tạo ra cảnh báo. Cảnh báo cần một con người, theo lịch, nhìn vào bức tranh tổng thể.
Đánh giá sức khỏe dữ liệu hằng tuần là ba mươi phút, cùng giờ mỗi tuần. Báo cáo độ trôi, báo cáo độ mới, lô mẫu. Người vận hành xem qua các báo cáo và trả lời một câu hỏi: dữ liệu có còn là thứ mô hình nghĩ không? Hầu hết các tuần câu trả lời là có và cuộc họp rất ngắn. Những tuần không phải vậy là những tuần buổi đánh giá chứng minh giá trị — sự mục nát bị bắt ở giai đoạn pipeline, trước khi mô hình có một tuần để học nó.
Buổi đánh giá cũng là nơi diễn ra kiểm tra ngữ nghĩa. Chủ sở hữu lĩnh vực xem một mẫu dữ liệu và đầu ra của mô hình, đánh dấu những thay đổi thầm lặng mà phân phối không thấy được. Buổi đánh giá là lớp con người khiến các kiểm tra tự động trở nên đáng tin — kiểm tra nói thứ gì đã dịch chuyển, con người nói sự dịch chuyển đó có quan trọng không.
Vòng lặp giữ cho mô hình trung thực
Đánh giá sức khỏe dữ liệu có đầu ra thứ hai ngoài cảnh báo: nó nuôi bộ đánh giá (eval suite). Sự dịch chuyển phân phối trở thành một ca đánh giá mới. Sự thay đổi ngữ nghĩa trở thành một mục trong bộ chuẩn vàng. Sự mục nát bị bắt trở thành một bài kiểm tra hồi quy, để lần sau cùng hình dạng thay đổi xuất hiện, bộ đánh giá sẽ bắt được trước cả buổi đánh giá.
Đó là vòng lặp tích lũy. Mỗi sự cố mục nát khiến hệ thống giỏi hơn trong việc bắt sự cố tiếp theo, vì mỗi lần thêm một ca vào bộ đánh giá và một kiểm tra vào pipeline. Đánh giá sức khỏe dữ liệu thôi là một việc nhàm chán, mà trở thành bộ cảm biến giữ cho toàn hệ thống trung thực.
Mô hình học thứ bạn nạp cho nó. Sự mục nát nằm trong việc nạp. Kiểm tra phân phối, kiểm tra độ mới, kiểm tra ngữ nghĩa, một buổi đánh giá hằng tuần, và một vòng lặp biến mọi lần phát hiện thành một bài kiểm tra. Đó là thực hành, và là sự khác biệt giữa một mô hình luôn sắc bén và một mô hình chậm rãi, thầm lặng học cách sai. Hãy theo dõi dữ liệu. Mô hình sẽ tự lo phần còn lại.
Nghĩ rằng lập luận này phù hợp với sự kiện của bạn? Hãy kể cho tôi về hội trường — lịch có chọn lọc.
Bắt đầu trò chuyện