Testing AI Outputs the Way You Test Code

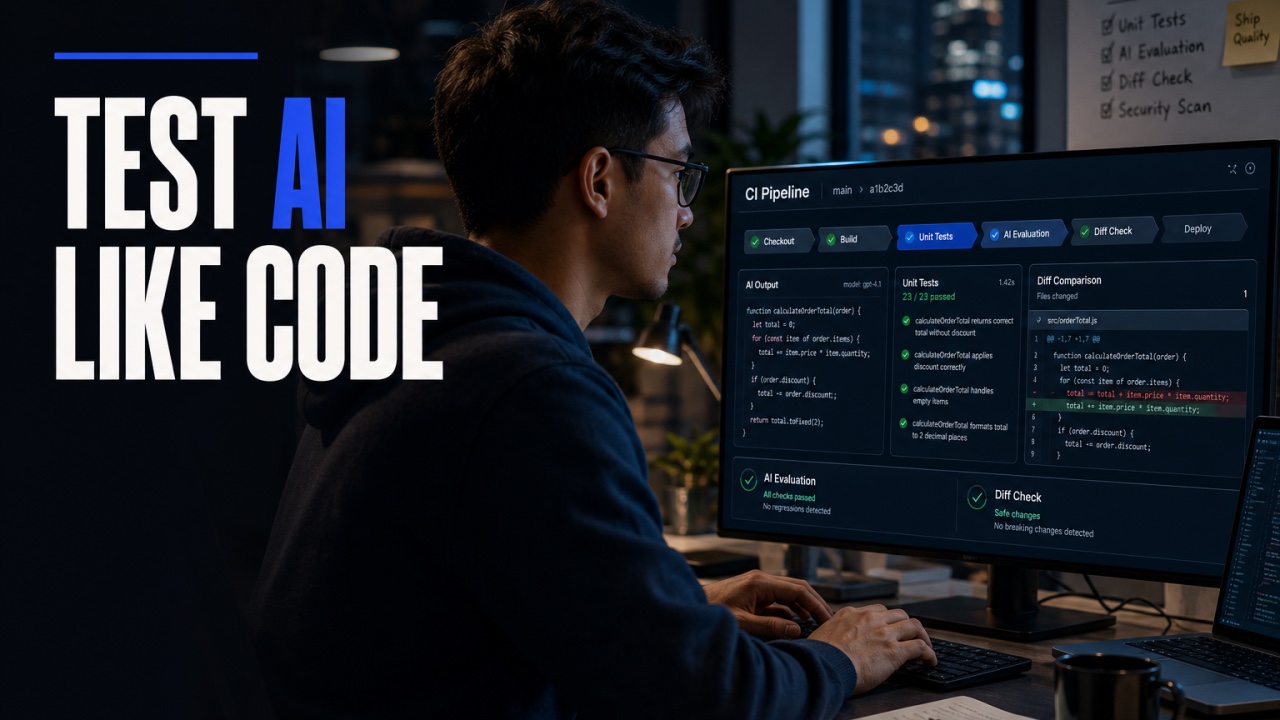
软件团队花了四十年学会如何安全地发布变更。AI 团队正在用最痛苦的方式重新学一遍——一次一个生产事故。
问题出在心智模型。传统软件测试往往假设结果是可预测的:跑测试、看输出、信任结果。AI 输出会变化,即使输入相同。于是团队二选一:要么把 AI 当普通代码,结果被烧伤;要么认定 AI 没法测,凭信仰上线。
两者都错了。AI 是可以测的。它需要能应对输出变化的测试技术。这些技术很多在软件交付里已经存在。要做的只是把它们适配到 AI 上。
影子模式:在暴露给用户之前先测
影子模式让你把一个候选模型和当前模型并排跑,用同一批线上输入,但不让候选的输出到达用户。
当前模型继续服务。候选模型产出答案,进入评估日志,在那里可以对照你的评估标准打分。这给了你演示给不了的东西:候选模型在你的真实流量、真实输入、真实边缘情况上表现如何。
对于会采取行动的系统,影子模式还意味着阻止候选模型做出改动。它可以提议发一封邮件或更新一条记录。但它不能真的去做。
跑足够长,覆盖有代表性的工作范围。一个工作流可能一周就够。另一个可能要跑完一个月结周期,对比才有意义。
影子模式在你把用户暴露给变更之前,先给你证据。
金丝雀:发布给一小片
下一步是金丝雀:把候选发布给一小片受控流量——百分之五、百分之十——然后观察。
现在输出到达用户了,所以对比从答案质量延伸到运营结果。升级率。否决率。错误标记。每个任务成本。人们得到更好的结果了吗?他们做更多清理了吗?这个改进值得这个成本吗?
对比需要可比的工作。如果候选拿到的是简单请求,当前模型拿到的是难请求,数字就不会告诉你这个变更有没有用。
在金丝雀开始之前就定好什么叫成功,包括什么会触发回滚。如果候选表现更差,趁暴露面还小就撤回来。
这个纪律很熟悉:小步发布,测量差异,用数据做决定。
冠军/挑战者:让对比持续下去
冠军/挑战者让对比成为持续实践。当前模型是冠军。候选是挑战者,通过影子流量或受控的线上分配来评估。
这是你捕捉两次发布之间变化的方式。你的输入在变。客户行为在变。业务规则在演进。一月份表现很好的模型,可能处理不好六月份进来的工作。
一个常设的对比,能帮你发现什么时候另一个候选能更好地处理那批工作。晋升成为一个有证据支撑的决定。
它也给了你评估供应商更新的办法。供应商发布新版本,说它更好。这个说法要走一遍你的评估流程。如果新版本在你的工作上打败冠军、又满足你的运营要求,就晋升它。如果不行,发布公告不是切换的理由。
输出的回归套件
在这一切的底下,是回归套件:一组维护中的用例,每个候选都必须通过。
从你的黄金集合开始——你用来评估质量的那些代表性例子。加上那些暴露过真实失败的用例、对客户重要的边缘情况、以及答错会带来实际代价的场景。
因为输出会变化,通过并不总意味着匹配某个精确的句子。它可以是:事实对、遵循业务规则、产出要求的结构、或在系统不该行动时升级。
对高风险用例,要反复测。一次好答案不能确立可靠性。
套件给了你跨候选的一致基线。一个提高了平均分、却破坏了关键工作流的候选,还没有赢得晋升。
影子模式展示候选如何处理当前流量。回归套件检查它是否仍能处理你已知重要的那些用例。两者你都需要。
实践中的阶梯
发布顺序从回归套件开始。如果候选没通过要求的阈值,就停在这里。
接下来是有代表性线上流量上的影子模式。给输出打分,调查失败,检查这个表面上的改进在精选测试集之外是否还成立。
然后是一个受控的金丝雀。对照当前模型比较运营结果,用清晰的阈值决定扩大发布还是回滚。
如果候选通过了这些关卡,它就能成为冠军。监控继续,下一个挑战者走同样的流程。
这套纪律也应该覆盖提示词、检索、工具、业务规则的变更。它们任何一个都能改变系统行为,即使模型不变。
底下是回归套件。暴露之前有影子。广泛发布之前有金丝雀。发布之后有持续对比。
这些技术让软件部署变得日常。它们也能给 AI 带来同样的纪律。
输出可能会变化。发布流程仍然可以保持一致。这就是 AI 变更从生产事故变成有据可循的决策的方式。