Testing AI Outputs the Way You Test Code

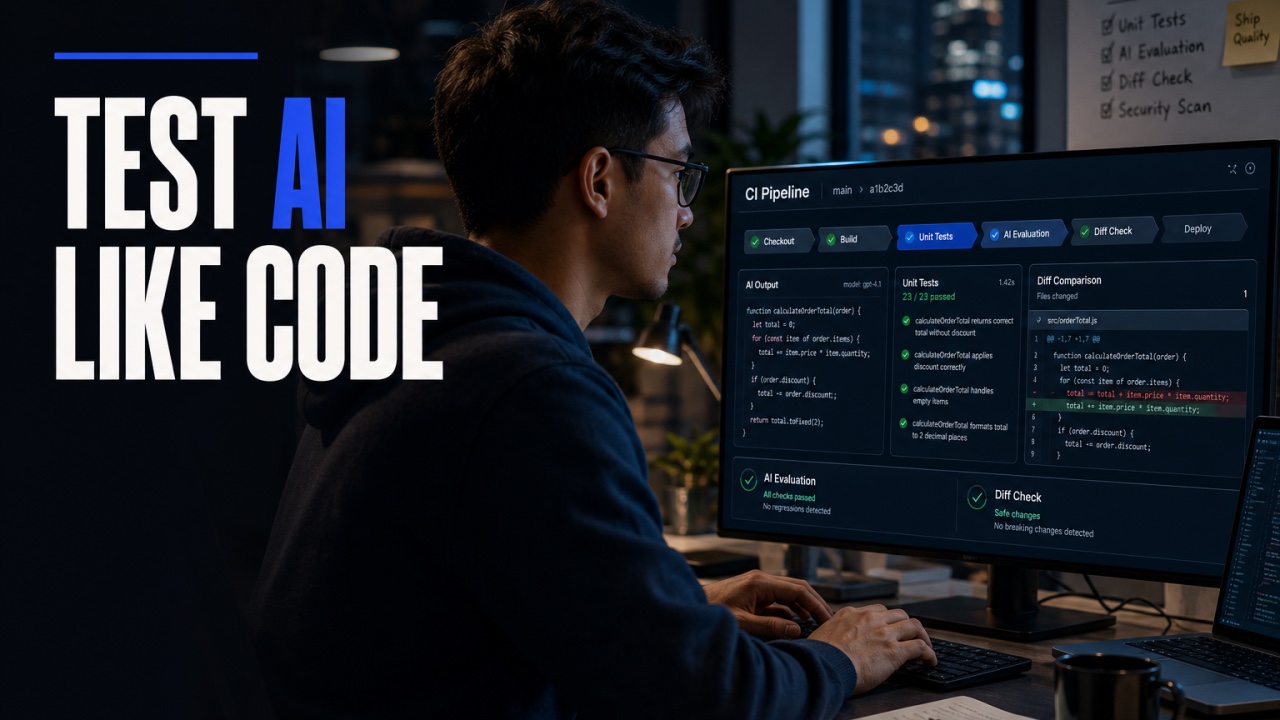
Các đội phần mềm đã mất bốn mươi năm để học cách phát hành thay đổi một cách an toàn. Các đội AI đang học lại điều đó theo cách khó khăn, từng bất ngờ production một lần.
Vấn đề nằm ở mô hình tư duy. Kiểm thử phần mềm truyền thống thường giả định kết quả dự đoán được: chạy test, xem output, tin kết quả. Output AI có thể thay đổi, kể cả cùng một input. Nên các đội làm một trong hai việc: coi AI như code thường và bị thiêu cháy, hoặc kết luận AI không test được và phát hành theo niềm tin.
Cả hai đều sai. AI có thể test được. Nó cần các kỹ thuật kiểm thử tính đến output thay đổi. Nhiều kỹ thuật trong số đó đã tồn tại trong phát hành phần mềm. Việc cần làm là thích nghi chúng cho AI.
Shadow mode: test trước khi đưa ra người dùng
Shadow mode cho bạn chạy một ứng viên song song với model hiện tại, trên cùng các input live, mà không để output của ứng viên đến tay người dùng.
Model hiện tại tiếp tục phục vụ. Ứng viên tạo ra câu trả lời đi vào log đánh giá, nơi chúng được chấm theo tiêu chí đánh giá của bạn. Điều đó cho bạn phép so sánh mà demo không có: ứng viên thể hiện thế nào trên traffic thật, input thật, và edge case thật của bạn.
Với các hệ thống thực hiện hành động, shadow mode còn nghĩa là ngăn ứng viên thực hiện thay đổi. Nó có thể đề xuất gửi email hay cập nhật bản ghi. Nhưng nó không được thực sự làm.
Chạy đủ lâu để bao phủ một phạm vi công việc đại diện. Một tuần có thể đủ cho một workflow. Workflow khác có thể cần một chu kỳ cuối tháng thì so sánh mới có ý nghĩa.
Shadow mode cho bạn bằng chứng trước khi bạn đưa người dùng tiếp xúc với thay đổi.
Canary: phát hành cho một lát nhỏ
Bước tiếp theo là canary: đưa ứng viên ra một lát traffic nhỏ, có kiểm soát — năm phần trăm, mười phần trăm — và quan sát.
Giờ output đến tay người dùng, nên so sánh vượt qua chất lượng câu trả lời để đến kết quả vận hành. Tỷ lệ leo thang. Tỷ lệ ghi đè. Cờ lỗi. Chi phí mỗi tác vụ. Người ta có kết quả tốt hơn không? Họ có phải dọn dẹp nhiều hơn không? Cải thiện có đáng chi phí không?
So sánh cần công việc tương đương. Nếu ứng viên nhận các yêu cầu dễ còn model hiện tại nhận yêu cầu khó, con số sẽ không cho bạn biết thay đổi có giúp ích không.
Quyết định thế nào là thành công trước khi canary bắt đầu, bao gồm cả điều gì kích hoạt rollback. Nếu ứng viên tệ hơn, hãy kéo về khi mức phơi nhiễm còn hạn chế.
Kỷ luật này rất quen: phát hành nhỏ, đo khác biệt, quyết định bằng dữ liệu.
Champion/challenger: giữ so sánh luôn sống
Champion/challenger biến so sánh thành một thực hành liên tục. Model hiện tại là champion. Ứng viên là challenger, được đánh giá qua shadow traffic hoặc một phân bổ live có kiểm soát.
Đây là cách bạn bắt các thay đổi xảy ra giữa các lần phát hành. Input của bạn dịch chuyển. Hành vi khách hàng đổi. Quy tắc kinh doanh tiến hóa. Một model hoạt động tốt hồi tháng Một có thể kém trên công việc đến vào tháng Sáu.
Một so sánh thường trực giúp lộ ra khi nào một ứng viên khác xử lý công việc đó tốt hơn. Việc thăng cấp trở thành quyết định có bằng chứng.
Nó cũng cho bạn cách đánh giá bản cập nhật của nhà cung cấp. Nhà cung cấp phát hành phiên bản mới và nói nó tốt hơn. Tuyên bố đó phải đi qua quy trình đánh giá của bạn. Nếu phiên bản mới đánh bại champion trên công việc của bạn và đáp ứng yêu cầu vận hành, hãy thăng cấp nó. Nếu không, thông báo phát hành không phải lý do để chuyển.
Bộ hồi quy cho output
Bên dưới tất cả là bộ hồi quy: một tập hợp các ca được duy trì mà mọi ứng viên phải vượt qua.
Bắt đầu từ golden set của bạn — các ví dụ đại diện bạn dùng để đánh giá chất lượng. Thêm các ca từng lộ ra lỗi thật, các edge case quan trọng với khách hàng, và các tình huống mà câu trả lời sai mang chi phí đáng kể.
Vì output có thể thay đổi, vượt qua không luôn nghĩa là khớp một câu chính xác. Nó có thể là: đúng sự kiện, tuân theo quy tắc kinh doanh, tạo đúng cấu trúc, hoặc leo thang khi hệ thống không nên hành động.
Với các ca rủi ro cao, hãy test lặp lại. Một câu trả lời tốt không xác lập độ tin cậy.
Bộ này cho bạn một baseline nhất quán giữa các ứng viên. Một ứng viên cải thiện điểm trung bình nhưng phá vỡ một workflow quan trọng thì chưa đáng thăng cấp.
Shadow mode cho thấy ứng viên xử lý traffic hiện tại thế nào. Bộ hồi quy kiểm tra nó còn xử lý được các ca bạn đã biết là quan trọng không. Bạn cần cả hai.
Chiếc thang trong thực hành
Chuỗi phát hành bắt đầu với bộ hồi quy. Nếu ứng viên không qua ngưỡng yêu cầu, nó dừng ở đó.
Tiếp theo là shadow mode trên traffic live đại diện. Chấm điểm output, điều tra lỗi, và kiểm tra xem cải thiện bề ngoài có giữ được ngoài bộ test đã chọn không.
Rồi đến canary có kiểm soát. So sánh kết quả vận hành với model hiện tại, với ngưỡng rõ ràng để mở rộng hay rollback.
Nếu ứng viên vượt các cổng đó, nó có thể thành champion. Giám sát tiếp tục, và challenger tiếp theo đi qua cùng quy trình.
Kỷ luật đó cũng nên bao phủ các thay đổi về prompt, retrieval, tool, và quy tắc kinh doanh. Bất kỳ cái nào cũng có thể thay đổi hành vi hệ thống, kể cả khi model không đổi.
Bộ hồi quy ở dưới. Shadow trước khi phơi nhiễm. Canary trước khi phát hành rộng. Một so sánh liên tục sau phát hành.
Những kỹ thuật này từng giúp việc triển khai phần mềm trở nên thường nhật. Chúng có thể mang cùng kỷ luật đó cho AI.
Output có thể thay đổi. Quy trình phát hành vẫn có thể nhất quán. Đó là cách các thay đổi AI ngừng là bất ngờ production và bắt đầu là quyết định được đo lường.
Nghĩ rằng lập luận này phù hợp với sự kiện của bạn? Hãy kể cho tôi về hội trường — lịch có chọn lọc.
Bắt đầu trò chuyện